Lịch sử công nghệ — dựa trên tư liệu
Hai bàn cờ, hai cách kể chuyện về AI
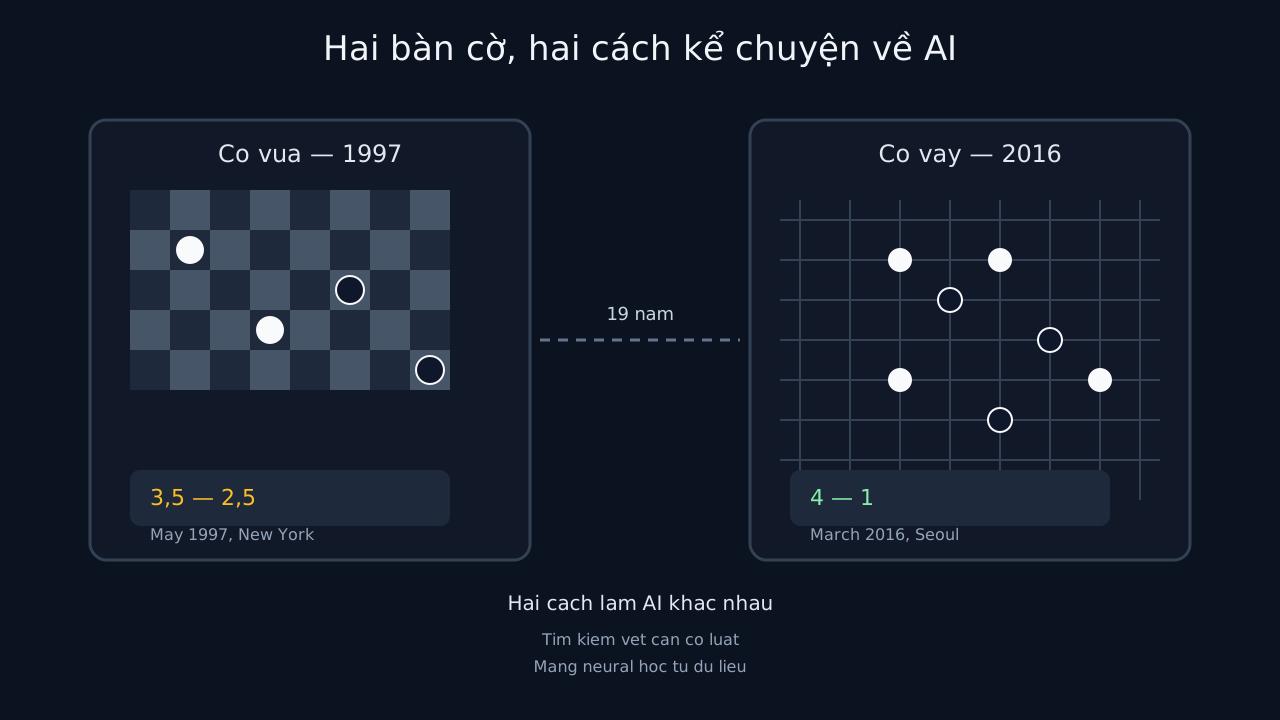
Deep Blue thắng Kasparov năm 1997 và AlphaGo thắng Lee Sedol năm 2016 thường được kể như một đường thẳng tiến bộ của AI — thực ra là hai kỹ thuật gần như không liên quan: vét cạn bằng tốc độ thô, và học từ dữ liệu.
InkViet — minh họa gốc với AI hỗ trợ; không phải ảnh tư liệu
Ngày 11 tháng 5 năm 1997, tại một tòa nhà ở New York, Garry Kasparov đứng dậy khỏi bàn cờ chỉ sau 19 nước ở ván 6, hai tay ôm đầu. Ông vừa thua. Không thua một trận giao hữu, mà thua cả loạt đấu 6 ván trước Deep Blue — chiếc máy của IBM — với tỷ số 3,5–2,5. Đây là lần đầu tiên một hệ thống máy tính đánh bại một nhà vô địch cờ vua đương nhiệm trong điều kiện thi đấu chuẩn, có giới hạn thời gian như mọi giải chuyên nghiệp [1]. Kasparov, giọng có vẻ không phục, vẫn phải nói: “Tôi phải ngả mũ. Chiếc máy mạnh hơn bất kỳ ai từng nghĩ” [1].
Deep Blue không phải phép màu bất ngờ. Nó là kết quả của hơn một thập kỷ làm việc, bắt đầu từ năm 1985 khi Feng-hsiung Hsu, một nghiên cứu sinh ở Carnegie Mellon, góp phần xây ChipTest — một máy chơi cờ từng thắng giải vô địch cờ máy Bắc Mỹ năm 1987. Hsu và Murray Campbell được IBM Research tuyển vào năm 1989 để biến ý tưởng đó thành Deep Blue [1]. Cách nó chơi cờ cũng không có gì bí ẩn hay “thông minh” theo nghĩa học hỏi: 32 bộ xử lý chạy song song, đánh giá 200 triệu vị trí cờ mỗi giây, tốc độ xử lý 11,38 tỷ phép tính dấu phẩy động mỗi giây — so với chiếc siêu máy tính đầu tiên của chính IBM, Stretch, ra đời năm 1961, chỉ đạt chưa tới 500 phép tính mỗi giây [1]. Nói cách khác: Deep Blue không “hiểu” cờ vua. Nó vét cạn khả năng, nhờ tốc độ thô mà con người không bao giờ theo được, cộng với một hàm đánh giá do con người viết sẵn để chấm điểm từng thế cờ.
Mười chín năm sau, một trận đấu khác diễn ra, nhưng là một loài máy hoàn toàn khác đứng ở phía đối diện bàn cờ — lần này là bàn cờ vây.
Tháng 10 năm 2015, AlphaGo của Google DeepMind thắng 5-0 trước Fan Hui, nhà vô địch châu Âu ba lần liên tiếp — trận đấu đầu tiên trong lịch sử giữa một hệ thống AI và một kỳ thủ cờ vây chuyên nghiệp. Năm tháng sau, AlphaGo đối đầu Lee Sedol, người giữ 18 danh hiệu vô địch thế giới và được xem là một trong những kỳ thủ vĩ đại nhất thập kỷ đó. Chiến thắng 4-1 của AlphaGo tại Seoul, Hàn Quốc, tháng 3 năm 2016 được hơn 200 triệu người trên toàn thế giới theo dõi [2]. Hai trăm triệu người xem — đúng con số từng xuất hiện ở Deep Blue, chỉ khác đơn vị: đó là 200 triệu vị trí cờ Deep Blue tính mỗi giây, còn đây là 200 triệu con người ngồi trước màn hình. Một sự trùng hợp về số, nhưng một khoảng cách rất xa về bản chất.
Vì cờ vây không chỉ là một bàn cờ lớn hơn. DeepMind gọi nó là trò chơi “phức tạp hơn cờ vua một googol lần” — tức 10 lũy 170 cấu hình bàn cờ có thể xảy ra, nhiều hơn số nguyên tử trong vũ trụ mà con người biết được [2]. Vét cạn theo kiểu Deep Blue là bất khả thi ở quy mô đó. AlphaGo không chơi bằng cách tính hết mọi khả năng. Nó dùng hai mạng neural: một “mạng chính sách” chọn nước đi tiếp theo, một “mạng giá trị” dự đoán ai sẽ thắng. DeepMind cho AlphaGo học từ hàng nghìn ván cờ của kỳ thủ con người trước, rồi để nó tự đấu với các phiên bản của chính mình hàng nghìn lần, học từ sai lầm của mình — cách học này gọi là học tăng cường [2]. Nó không được lập trình sẵn cách đánh giá một thế cờ vây. Nó tự học ra điều đó.
Hệ quả là một thứ Deep Blue không bao giờ có: AlphaGo đi những nước mà không ai lập trình, không ai dạy, và đôi khi không ai hiểu ngay lúc đó. Lee Sedol, sau một trong những ván đấu, nói: “Tôi từng nghĩ AlphaGo chỉ dựa trên tính toán xác suất, chỉ là một cái máy. Nhưng khi thấy nước đi đó, tôi đã đổi suy nghĩ. Rõ ràng, AlphaGo có sự sáng tạo” [2]. Một kỳ thủ hàng đầu thế giới gọi máy là “sáng tạo” — điều không ai từng nói về Deep Blue, vì không ai có thể nói Deep Blue sáng tạo gì cả. Nó chỉ tính nhanh hơn.
Đây là lý do câu chuyện “từ Deep Blue đến AlphaGo” rất dễ bị kể sai thành một đường thẳng tiến bộ: ngày càng mạnh hơn, ngày càng thông minh hơn. Thực ra đó là hai kỹ thuật gần như không liên quan. Deep Blue là brute-force — sức mạnh tính toán thô cộng quy tắc con người viết sẵn. AlphaGo là một hệ thống học từ dữ liệu và tự cải thiện qua trải nghiệm, thứ các mạng neural hiện đại vẫn đang dùng. Khi Deep Blue thắng xong, IBM tháo rời nó ngay sau trận New York — nó không chơi trận nào khác, không có “phiên bản sau”. Dòng máy của AlphaGo thì khác: DeepMind xác nhận các hậu duệ của nó — AlphaZero, MuZero, AlphaDev — vẫn tiếp tục giải những bài toán phức tạp khác cho tới hiện tại [2].
Cả hai câu chuyện đều là tư liệu do chính bên thắng — IBM và Google DeepMind — kể lại, nên không tránh được việc tô điểm cho sản phẩm của mình. IBM nhắc Deep Blue như bước đệm cho các dòng sản phẩm doanh nghiệp sau này; DeepMind gọi AlphaGo là “bằng chứng thuyết phục” cho hướng đi của cả công ty. Cả hai khẳng định đó nên được đọc như lời kể của người trong cuộc, không phải một đánh giá độc lập. Nhưng con số, ngày tháng và trích dẫn trực tiếp trong bài — tỷ số 3,5–2,5, tỷ số 4-1, tên những người đứng sau mỗi cỗ máy, câu nói của Kasparov và của Lee Sedol — đều lấy thẳng từ hai trang tư liệu chính thức đó, không phải suy đoán.
Hai bàn cờ, cách nhau 19 năm. Một bên là một cái máy tính nhanh đến mức không cần phải “hiểu” gì để thắng. Một bên là một cái máy học cách tự thắng mà không ai dạy nó từng nước cụ thể. Người ta vẫn hay gọi cả hai là “AI đánh bại con người” như thể đó là một câu chuyện. Thật ra là hai câu chuyện khác nhau, chỉ tình cờ đứng cạnh một bàn cờ.
Nguồn tham khảo
- IBM — Deep Blue (lịch sử chính thức) — truy cập 2026-10-27.
- Google DeepMind — AlphaGo (trang nghiên cứu chính thức) — truy cập 2026-10-27.
Bài viết có AI hỗ trợ, đã qua kiểm tra biên tập. Các nhận định riêng được phân biệt với dữ kiện có dẫn nguồn.